Nos últimos anos, o processamento de linguagem natural (NLP) ficou cada vez mais popular, e os chatbots se tornaram uma forma comum de se comunicar com clientes ou usuários. Com a ajuda de algoritmos de deep learning, os chatbots conseguem gerar respostas indistinguíveis das de um ser humano. Neste post, vamos ver como desenvolver nosso próprio modelo de chat GPT em Python, usando a arquitetura do GPT-2 como guia.
Antes de começar, vamos entender o que é o GPT. GPT significa "Generative Pre-trained Transformer" (Transformer Generativo Pré-treinado). É um algoritmo de deep learning que usa a arquitetura transformer para gerar texto em linguagem natural. Os modelos GPT são pré-treinados em grandes conjuntos de dados, como a Wikipédia, notícias, posts de blogs etc., e depois ajustados (fine-tuning) para tarefas específicas, como tradução ou análise de sentimentos.
O modelo GPT-2, lançado em 2019 pela OpenAI, é um dos modelos de linguagem mais avançados disponíveis hoje. Ele foi treinado em um grande conjunto de dados (aprox. 45 TB) de páginas web, notícias e livros. Isso permite que o modelo gere textos coerentes, parecidos com os de um humano, com um alto nível de precisão.
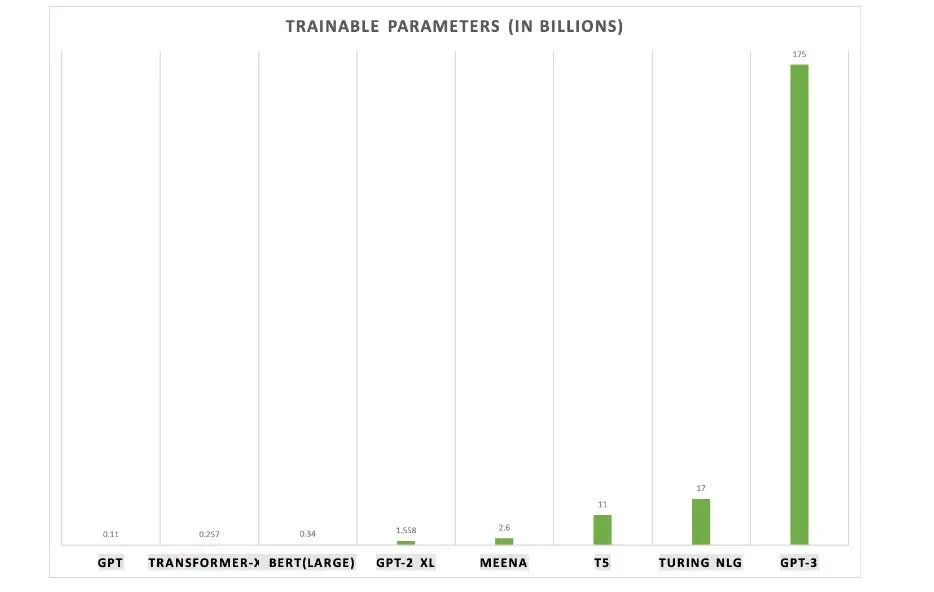
Outra coisa que torna o GPT-3 tão transformador é a enorme quantidade de parâmetros usada para treinar o modelo. O número passa de 170 bilhões, 10 vezes mais do que o maior modelo da época.
Agora, vamos mergulhar no código e ver como desenvolver um modelo parecido com o chat GPT em Python.
Passo 1: Instale as Bibliotecas Necessárias
Antes de tudo, precisamos instalar as bibliotecas necessárias. A mais importante é o TensorFlow, um framework de machine learning de código aberto desenvolvido pelo Google. O TensorFlow oferece as ferramentas de que precisamos para construir e treinar o modelo do nosso chatbot. Também precisamos instalar a biblioteca da Hugging Face, uma biblioteca de NLP popular que oferece modelos pré-treinados e ferramentas para fazer o fine-tuning deles.
Para instalar o TensorFlow, abra um terminal e digite o seguinte comando:
pip install tensorflow
Para instalar a biblioteca da Hugging Face, digite o seguinte comando:
pip install transformers
Passo 2: Defina os Dados
Agora, precisamos definir os dados com os quais o chatbot vai ser treinado. Podemos usar qualquer conjunto de dados de texto para isso. No entanto, para um chatbot, precisamos de um conjunto que contenha conversas. Podemos usar o Cornell Movie Dialogs Corpus, que reúne conversas entre personagens de filmes.
Para baixar o conjunto de dados, digite o seguinte comando:
wget http://www.cs.cornell.edu/~cristian/data/cornell_movie_dialogs_corpus.zip
Extraia o arquivo zip e abra o arquivo "movie_lines.txt". Ele contém as conversas entre os personagens dos filmes.
Passo 3: Pré-processe os Dados
Para usar esses dados no treinamento do chatbot, precisamos pré-processá-los. É preciso extrair as conversas do conjunto de dados e convertê-las para um formato que o modelo GPT-2 consiga usar.
Para isso, podemos usar o seguinte código Python:
import os
import csv

def get_conversations():
    conversations = []
    with open(os.path.join('cornell_movie_dialogs_corpus',
              'movie_lines.txt'), 'r', encoding='iso-8859-1') as f:
        lines = f.readlines()
        for line in lines:
            parts = line.strip().split(' +++$+++ ')
            if len(parts) == 5:
                conv_id = parts[0]
                line_text = parts[4]
                conversations.append((conv_id, line_text))
    return conversations
Esse código lê as conversas do arquivo "movie_lines.txt", extrai o ID e o texto de cada fala e grava tudo em um array formatado.
Passo 4: Treine o Modelo
Com os dados pré-processados, podemos começar a treinar nosso chatbot no estilo GPT. Para isso, precisamos definir a arquitetura do modelo, carregar o modelo GPT-2 pré-treinado da biblioteca da Hugging Face e fazer o fine-tuning dele com o nosso conjunto de conversas.
Aqui está o código Python para definir e treinar o modelo:
import tensorflow as tf
from transformers import TFGPT2LMHeadModel, GPT2Tokenizer

def train():
    tokenizer = GPT2Tokenizer.from_pretrained('gpt2')
    model = TFGPT2LMHeadModel.from_pretrained('gpt2')

    # Load the conversation dataset
    conversations = get_conversations()

    # Tokenize the conversations and create input/output pairs
    input_ids = []
    output_ids = []
    for i in range(len(conversations) - 1):
        input_text = conversations[i][1]
        output_text = conversations[i + 1][1]
        input_tokenized = tokenizer.encode(input_text,
                add_special_tokens=False)
        output_tokenized = tokenizer.encode(output_text,
                add_special_tokens=False)
        input_ids.append(input_tokenized)
        output_ids.append(output_tokenized)

    # Pad the input/output pairs to the same length
    max_length = max(len(ids) for ids in input_ids + output_ids)
    input_ids = \
        tf.keras.preprocessing.sequence.pad_sequences(input_ids,
            maxlen=max_length, padding='post')
    output_ids = \
        tf.keras.preprocessing.sequence.pad_sequences(output_ids,
            maxlen=max_length, padding='post')

    # Define the training parameters
    batch_size = 16
    epochs = 10
    optimizer = tf.keras.optimizers.Adam(learning_rate=5e-5)

    # Compile the model
    model.compile(optimizer=optimizer, loss=model.compute_loss)

    # Train the model
    model.fit(input_ids, output_ids, batch_size=batch_size,
              epochs=epochs)

    # Save the trained model
    model.save_pretrained('chatbot_model')
Esse código primeiro carrega o tokenizer e o modelo GPT-2 da biblioteca da Hugging Face. Em seguida, tokeniza as conversas e cria pares de entrada e saída. Depois, faz o padding desses pares para que todos tenham o mesmo tamanho e define os parâmetros de treinamento, como o tamanho do batch e a taxa de aprendizado.
Por fim, ele compila e treina o modelo com o conjunto de conversas, usando o otimizador Adam e o método compute_loss do modelo. Depois do treinamento, salva o modelo treinado em disco.
Passo 5: Teste o Modelo
Depois de treinar o modelo, podemos testá-lo gerando respostas para o que o usuário digitar. Para isso, carregamos o modelo treinado e o usamos para gerar texto a partir da entrada do usuário.
Aqui está o código Python para testar o modelo:
def test():
    tokenizer = GPT2Tokenizer.from_pretrained("gpt2")
    model = TFGPT2LMHeadModel.from_pretrained("chatbot_model")

    while True:
        input_text = input("User: ")
        input_tokenized = tokenizer.encode(input_text, add_special_tokens=False)
        input_ids = tf.keras.preprocessing.sequence.pad_sequences([input_tokenized], maxlen=max_length, padding="post")
        output_ids = model.generate(input_ids, max_length=max_length, num_beams=5, no_repeat_ngram_size=2, early_stopping=True)
        output_text = tokenizer.decode(output_ids[0], skip_special_tokens=True)
        print("Bot:", output_text)
Esse código primeiro carrega o modelo e o tokenizer treinados. Depois, pede uma entrada ao usuário, tokeniza essa entrada e gera uma resposta usando o método generate do modelo. Por fim, decodifica a saída gerada e a exibe para o usuário.
E é isso! Criamos nosso próprio modelo de chatbot. Você pode personalizá-lo quanto quiser, ajustando os parâmetros ou trocando o conjunto de dados para que as respostas atendam melhor às suas necessidades. Logo abaixo estão algumas dicas de como continuar o desenvolvimento, e aqui está o link para o Notebook Python que deixei com esse código 100% funcionando. Lembre-se de fazer o upload do conjunto de dados na raiz do projeto!
Extra: Melhorando o Modelo
Com um modelo básico de chatbot funcionando, podemos começar a melhorar sua performance ou personalizá-lo. Aqui estão algumas coisas que podemos fazer:
- Fazer o fine-tuning com um conjunto de dados maior: podemos ajustar o modelo com um conjunto maior de dados de conversas para melhorar sua capacidade de gerar respostas de qualidade.
- Experimentar outras arquiteturas de modelo: podemos testar arquiteturas diferentes, como o GPT-3 ou outros modelos baseados em transformers, para ver se eles se saem melhor que o GPT-2.
- Adicionar dados de treinamento próprios: podemos adicionar dados de treinamento personalizados para ajudar o modelo a gerar respostas específicas para o nosso caso de uso.
- Incorporar o feedback dos usuários: podemos incorporar o feedback dos usuários permitindo que eles avaliem a qualidade das respostas e usando essas avaliações para retreinar o modelo.
Conclusão
Hoje vimos como desenvolver um modelo de chatbot no estilo GPT em Python usando a biblioteca da Hugging Face. Passamos pelas etapas de pré-processamento dos dados, treinamento e teste do modelo, além de formas de melhorar sua performance.
Com um pouco de trabalho, conseguimos criar um modelo de chatbot capaz de gerar respostas de qualidade para o que o usuário digitar. Isso pode ser uma ferramenta valiosa para empresas e organizações que precisam oferecer atendimento ao cliente ou interagir com usuários nas redes sociais.
Referências
- Hugging Face Transformers Documentation: https://huggingface.co/transformers/
- GPT-2 Explained: A Complete Guide to the OpenAI Model: https://towardsdatascience.com/gpt-2-explained-a-complete-guide-to-the-openai-model-ef1d2546c84d
- How to Fine-Tune GPT-2 for Text Generation (using PyTorch): https://towardsdatascience.com/how-to-fine-tune-gpt-2-for-text-generation-using-pytorch-2ee61a4f1ba7
- Chatbot Tutorial: How to Build a Chatbot from Corpus to Deployment: https://www.analyticsvidhya.com/blog/2020/01/how-to-build-your-own-chatbot-nlp/
- How to Develop a Chatbot Using PyTorch: https://www.analyticsvidhya.com/blog/2021/03/how-to-develop-a-chatbot-using-pytorch/
- Cristian Danescu-Niculescu-Mizil, & Lillian Lee (2011). Chameleons in imagined conversations: A new approach to understanding coordination of linguistic style in dialogs.. In Proceedings of the Workshop on Cognitive Modeling and Computational Linguistics, ACL 2011.
- OpenAI GPT-3: Everything You Need to Know: https://www.analyticsvidhya.com/blog/2021/03/how-to-develop-a-chatbot-using-pytorch/